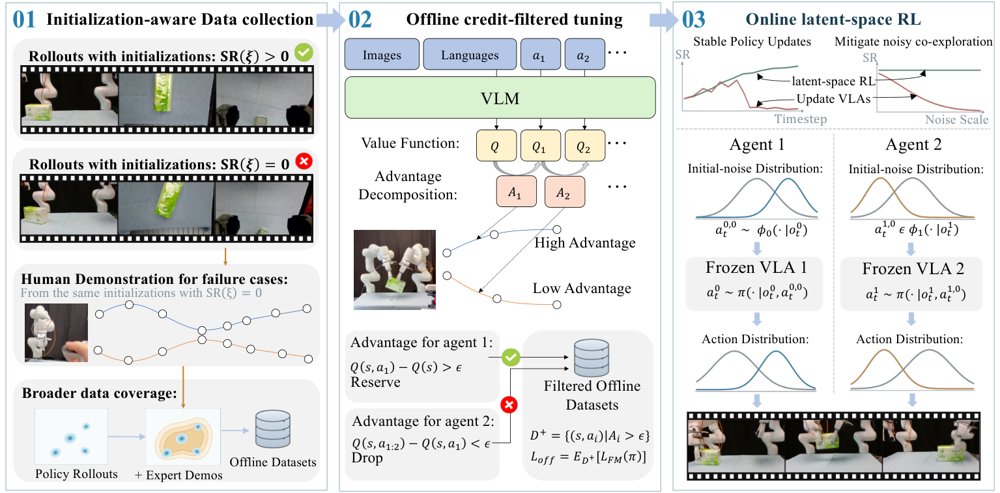
Cooperative Multi-Agent Vision-Language-Action Models via Reinforced Fine Tuning
作者:Ruixiao Xu, Wong Lik Hang Kenny, Zhiqian Liu, Jianing Guo, Hanxiao Li, Kejian Shi, Shuning Zhang, Pu Feng, Yongjia Ma, Yuqing Ma, Kai Chen, Qi Dou, Yaodong Yang, Xianglong Liu, Simin Li · 单位:Beihang University, The Chinese University of Hong Kong, PKU-Psibot Lab, Tsinghua University, Zhongguancun Laboratory, Li Auto Inc., Peking University · 会议/期刊:arXiv preprint · 方向:cs.RO · 发布日期:2026-09-30