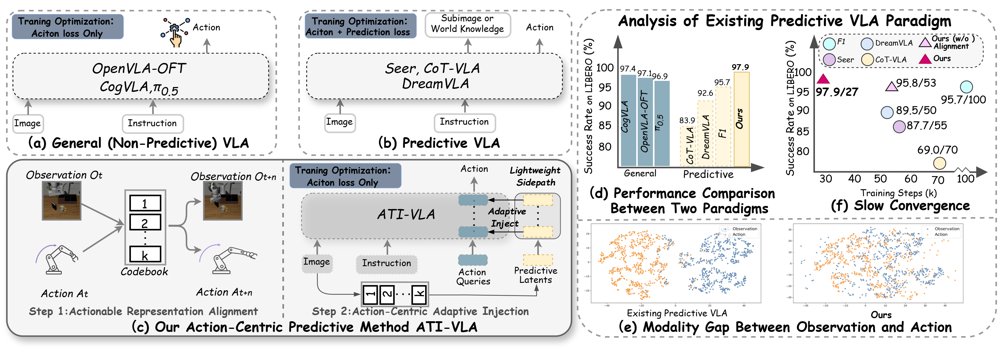
ATI-VLA: Action-Centric Predictive Vision-Language-Action Models via Actionable Alignment Then Adaptive Injection
作者:Yijie Zhu, Rui Shao, Jie He, Wei Li, Bo Zhao, Yelin Wang, Xiaochen Yuan, Tao Tan, Miao Zhang, Xiaojiang Peng, Zitong Yu · 单位:Harbin Institute of Technology, Shenzhen, Institute for Artificial Intelligence, Great Bay University, Shenzhen Loop Area Institute, Macao Polytechnic University, Shenzhen Technology University, Dongguan Key Laboratory for Intelligence and Information Technology · 会议/期刊:arXiv preprint · 方向:cs.CV · 发布日期:2026-10-02