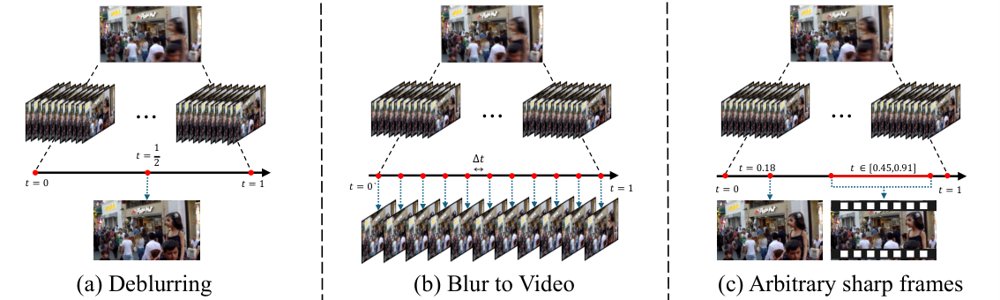
PickMoment: Continuous-Time Single-Image-to-Video via Learning Deblurring and Blur-to-Video
作者:Junseong Shin, Hyeonsu Jo, Daehyun Kim, Tae Hyun Kim · 单位:Department of Artificial Intelligence, Hanyang University, Department of Intelligence Convergence, Hanyang University, Department of Computer Science, Hanyang University · 会议/期刊:arXiv preprint · 方向:cs.CV · 发布日期:2026-10-02