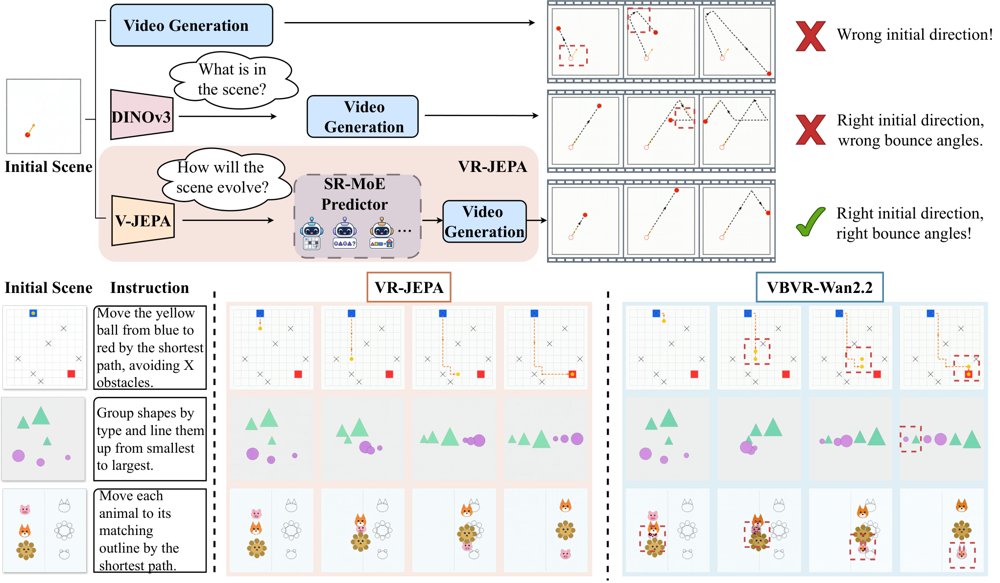
VR-JEPA: Learning Contrastive-State Latent Guidance for Generation-based Video Reasoning
作者:Zehua Ma, Kun Xiang, Yunshuang Nie, Quanlin Chen, Haoyuan Li, Xiuwei Chen, Jiang Ji, Haijun Wu, Zhenyu Xie, Michael Kampffmeyer, Hanhui Li, Xiaodan Liang · 单位:Shenzhen Campus of Sun Yat-sen University, Shenzhen Loop Area Institute, Tsinghua Shenzhen International Graduate School, Mohamed bin Zayed University of Artificial Intelligence, UiT The Arctic University of Norway · 会议/期刊:arXiv preprint · 方向:cs.CV · 发布日期:2026-10-01